Szybki start, nieprzewidywalne obciążenie
ReasonReach budowaliśmy po to, żeby ograniczyć ręczną pracę przy pozyskiwaniu klientów B2B: szukanie firm, zbieranie kontaktów, pisanie kolejnych maili i pilnowanie odpowiedzi. Zależało nam na szybkim uruchomieniu produktu. Równocześnie ważna była skalowalność, bo nie potrafiliśmy przewidzieć, kiedy przybędzie użytkowników i ile pracy wygenerują ich kampanie.
Sama liczba otwartych paneli niewiele mówi o obciążeniu takiej aplikacji. Przeglądanie listy firm to inna praca niż wyszukiwanie nowych kontaktów, sprawdzanie stron czy wysyłka wiadomości. Jedna aktywna kampania może uruchomić wiele operacji, z których część czeka na zewnętrzne serwisy.
Potrzebowaliśmy więc podziału, który pozwoli rozwijać te części osobno. Poniższy opis dotyczy obecnej architektury, uporządkowanej również w trakcie rozwoju projektu.
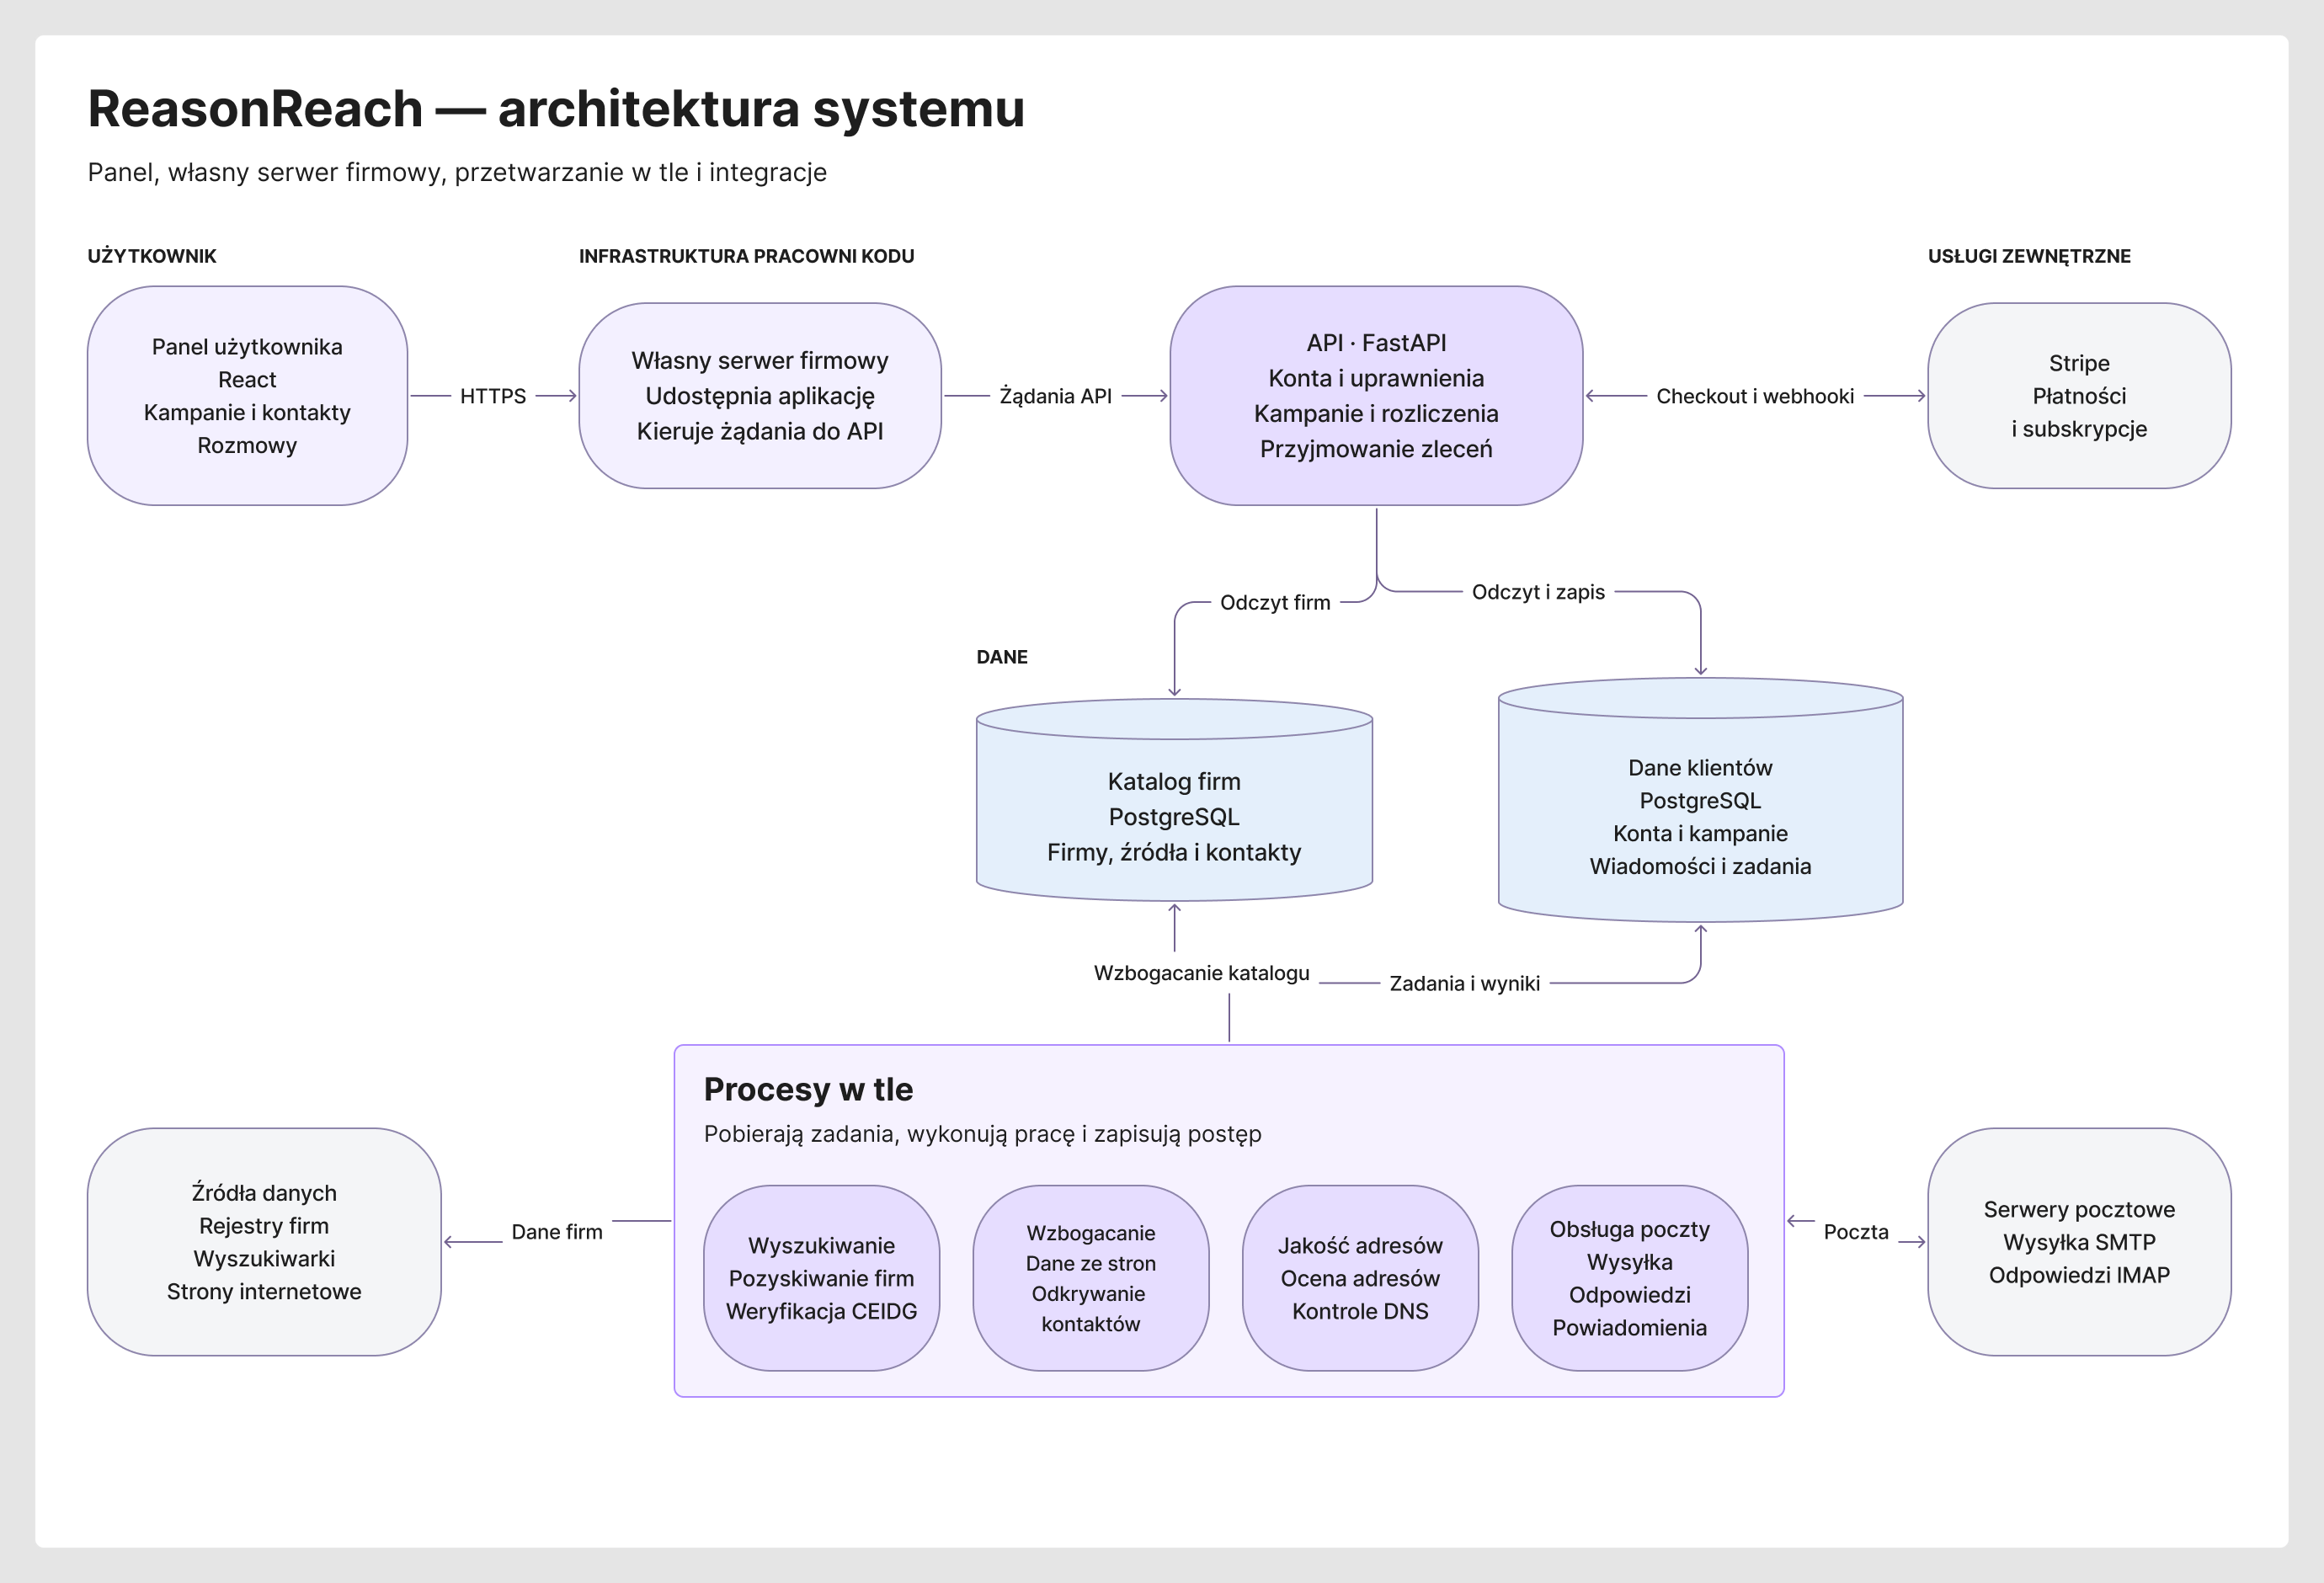
Co pokazuje diagram
Czytanie schematu warto zacząć od górnego rzędu. Panel w React jest miejscem pracy użytkownika: pokazuje kampanie, kontakty i rozmowy. Aplikację udostępnia własny serwer firmowy Pracowni Kodu. Obsługuje wejście do serwisu i przekazuje żądania panelu do API. Przeglądarka korzysta z jednego adresu aplikacji, a połączenie z backendem obsługuje nasza infrastruktura.
API w FastAPI sprawdza, kto wykonuje operację i do jakich danych ma dostęp. Obsługuje konta, zmiany w kampaniach oraz odczyt wyników. Przy dłuższej pracy jego zadaniem jest przyjąć zlecenie i zapisać je do wykonania. Użytkownik może potem sprawdzić postęp, zamiast utrzymywać jedno żądanie przez cały czas przetwarzania.
W środku są dwie bazy PostgreSQL. Katalog firm przechowuje firmy, źródła i kontakty. Baza klientów zawiera konta, kampanie, wiadomości oraz zadania i ich stan. Rozdzielenie tych odpowiedzialności pozwala rozwijać katalog niezależnie od struktury kampanii poszczególnych klientów. API korzysta z obu baz: pobiera firmy z katalogu, a operacje użytkownika i zlecenia zapisuje w bazie klientów.
Niżej pokazujemy procesy w tle, pogrupowane według pracy, którą wykonują. Wyszukiwanie pozyskuje firmy i obejmuje weryfikację w CEIDG. Wzbogacanie uzupełnia dane ze stron i odkrywa kontakty. Kontrola jakości ocenia adresy, między innymi przez sprawdzenia DNS. Obsługa poczty zajmuje się wysyłką, odpowiedziami i powiadomieniami. Te obszary mają w kodzie osobne procesy i komendy; nie są kolejnymi ekranami panelu.
Strzałki między procesami a bazami pokazują, skąd pobierają pracę i gdzie zapisują wyniki. API nie musi czekać na zakończenie całego wyszukiwania czy wysyłki. Panel odczytuje zapisany postęp przez API. Dzięki temu długie zadanie może trwać dalej, gdy użytkownik zamknie kartę przeglądarki.
Na obrzeżach są usługi zewnętrzne. Procesy wyszukiwania i wzbogacania korzystają z rejestrów firm, wyszukiwarek i stron internetowych. Obsługa poczty łączy się z serwerami SMTP przy wysyłce i IMAP przy odbieraniu odpowiedzi. API współpracuje ze Stripe przy uruchamianiu płatności i odbieraniu zdarzeń dotyczących rozliczeń. Te połączenia mają własne limity i mogą zawodzić — nie traktujemy ich jak zwykłego wywołania funkcji wewnątrz programu.
Dlaczego pracę przenieśliśmy do tła
Gdyby API wykonywało całą operację podczas jednego żądania, czas odpowiedzi zależałby również od wyszukiwarki, przeglądanej strony czy serwera pocztowego. Przy większej liczbie kampanii długie operacje zajmowałyby zasoby potrzebne do obsługi panelu. Oddzielenie ich daje nam możliwość dobierania zasobów dla API i automatyzacji według różnych potrzeb.
Kolejka pozwala przyjąć pracę szybciej, niż da się ją chwilowo wykonać. Procesy w tle mogą odbierać zadania we własnym tempie. Microsoft opisuje tę zasadę jako Queue-Based Load Leveling: buforowanie pracy ogranicza wpływ nagłych skoków zapotrzebowania na usługę wykonawczą.[2]
To odpowiadało naszemu celowi skalowalności. Przy wzroście obciążenia mamy osobne miejsce na zwiększanie zasobów lub równoległości przetwarzania. Nie trzeba przy tym przenosić wyszukiwania czy wysyłki z kodu obsługującego żądania — ten podział już istnieje.
Więcej workerów pomaga jednak tylko wtedy, gdy reszta systemu może przyjąć ich pracę. Trzeba sprawdzić sposób przydzielania zadań, limity skrzynek, liczbę połączeń z bazą i możliwości dostawców. Jeśli zadania stale napływają szybciej, niż są wykonywane, kolejka będzie rosła. Użytkownik zapłaci za to dłuższym oczekiwaniem. Sam podział procesów nie oznacza też, że automatyczne skalowanie jest już skonfigurowane.
Dlaczego zadanie trafia do PostgreSQL
Przyjęta praca musi przetrwać zakończenie żądania i restart procesu. W ReasonReach przechowujemy zlecenia w bazie, z której korzysta aplikacja. To pozwala powiązać zadanie ze stanem kampanii czy wiadomości i korzystać z transakcji. Utrzymanie tego mechanizmu pozostaje częścią utrzymania PostgreSQL.
Konkretny przykład z kodu to odpowiedź wysyłana z rozmowy. API zapisuje wiadomość i wpis w tabeli campaign_reply_outbox w jednej transakcji. Albo oba zapisy zostaną zatwierdzone, albo żaden. Unikamy w ten sposób sytuacji, w której aplikacja zapisała wiadomość, ale zgubiła osobne zlecenie jej wysłania. To zastosowanie idei transactional outbox, opisanej również w materiałach AWS.[3]
Proces wysyłkowy rezerwuje gotowe odpowiedzi za pomocą FOR UPDATE … SKIP LOCKED. Pomija wiersz zajęty przez inną transakcję, zamiast czekać na jego blokadę. Dokumentacja PostgreSQL wskazuje tabele kolejkowe z wieloma konsumentami jako jedno z zastosowań tego mechanizmu.[4] W tym przepływie pozwala to rozdzielać pobieranie zadań bez rezerwowania tego samego wpisu jednocześnie.
Osobny broker wiadomości byłby inną możliwością, z własnymi mechanizmami dostarczania i obsługi kolejek. Oznaczałby też kolejną usługę oraz konieczność uzgodnienia zapisu danych z publikacją zadania. Obecne rozwiązanie mieści te dwa zapisy w jednej bazie. Jego kosztem jest dodatkowe obciążenie PostgreSQL przez kolejkę; przy dalszym wzroście trzeba je mierzyć.
Pozostaje jeszcze kontakt z serwerem pocztowym. Może on przyjąć wiadomość, a połączenie urwać się przed potwierdzeniem. W obsłudze odpowiedzi przewidzieliśmy stan niepewnego dostarczenia i nie kierujemy takich prób automatycznie ponownie do kolejki. Blokada w bazie pomaga przydzielić zadanie, lecz nie daje gwarancji, że odbiorca otrzyma mail dokładnie raz.
Dlaczego wspólne moduły
Rozdzielenie procesów nie wymaga kopiowania reguł produktu. API i workery korzystają ze wspólnego pakietu reasonreach-core. W jego wnętrzu są obszary odpowiadające zadaniom aplikacji: katalog, pozyskiwanie, kampanie, poczta, konta i rozliczenia. Ten pakiet działa wewnątrz procesu, który go importuje; nie jest dodatkowym serwerem na diagramie.
Dzięki temu warunek uruchomienia kampanii ma swojego właściciela w kodzie, a reguły rozliczeń mają innego. Łatwiej znaleźć miejsce zmiany i użyć tej samej implementacji w kilku procesach. Richards i Ford opisują taki problem przez spójność modułu oraz zależności pomiędzy modułami. Ich rozróżnienie architektury logicznej i fizycznej jest tu przydatne: granica w kodzie nie musi być granicą usługi sieciowej.[1]
Osobna usługa dla każdego obszaru dałaby większą niezależność wdrożeń, ale wymagałaby utrzymania kontraktów sieciowych, obsługi awarii połączeń i koordynacji danych. Martin Fowler opisuje te koszty w Microservice Trade-Offs.[5] Przy naszym celu szybkiego rozwoju wspólne moduły pozwalają zachować podział odpowiedzialności bez dokładania sieci do każdej operacji.
Płacimy za to powiązaniem wersji. Zmiana wspólnego kontraktu może wymagać aktualizacji API i workerów. Dlatego ten układ opisujemy jako modułowy kod uruchamiany przez różne aplikacje, a nie zbiór całkowicie niezależnych mikroserwisów.
Gdzie ten podział ma swoje granice
Dla ReasonReach ten układ ma sens, ponieważ oddziela krótkie interakcje użytkownika od długiej, nierównomiernej pracy automatyzacji. Pozwala też rozwijać reguły produktu w jednym miejscu. To dwa praktyczne zyski przy szybkim starcie i niepewnym tempie wzrostu.
Wspólna warstwa danych pozostaje jednak wspólnym ograniczeniem. Zwiększenie liczby procesów może nasilić konkurencję o połączenia i blokady. Awaria bazy dotknie zarówno API, jak i przetwarzania w tle. Podobnie dodatkowe workery nie zwiększą limitu wysyłki u dostawcy poczty.
Przy dalszym skalowaniu trzeba więc patrzeć na czas oczekiwania zadań, tempo ich wykonywania, opóźnienia API oraz obciążenie bazy. Te pomiary pomogą rozstrzygnąć, czy potrzebujemy więcej procesów, lepszych zapytań, innego podziału pracy czy osobnej infrastruktury kolejkowej. Architektura zostawia nam te możliwości; wybór kolejnego kroku powinien wynikać z tego, co faktycznie zaczyna ograniczać system.
Planujesz własny produkt SaaS lub system dla firmy? Zobacz, jak w Pracowni Kodu podchodzimy do tworzenia oprogramowania dedykowanego i aplikacji — od ustalenia pierwszej wersji po wdrożenie i dalszy rozwój.
Źródła i dalsza lektura
Opis ReasonReach wynika z kodu projektu. Poniższe materiały rozwijają zasady, które pomagają ocenić przyjęte rozwiązania.
- Mark Richards, Neal Ford, Fundamentals of Software Architecture: A Modern Engineering Approach, wyd. 2, O’Reilly Media, 2025. Kompromisy architektoniczne, modularność oraz architektura logiczna i fizyczna: s. 6, 37–44, 110–111.
- Microsoft, Azure Architecture Center, Queue-Based Load Leveling pattern. Buforowanie skoków obciążenia oraz ograniczenia kolejek i skalowania konsumentów.
- AWS Prescriptive Guidance, Transactional outbox pattern. Wspólna transakcja dla danych i zlecenia, problem dwóch zapisów oraz możliwość duplikatów.
- PostgreSQL Documentation, SELECT — The Locking Clause. Działanie
SKIP LOCKEDi jego zastosowanie w tabelach kolejkowych. - Martin Fowler, Microservice Trade-Offs, 2015. Korzyści z rozdzielenia usług i koszty komunikacji, spójności danych oraz eksploatacji.