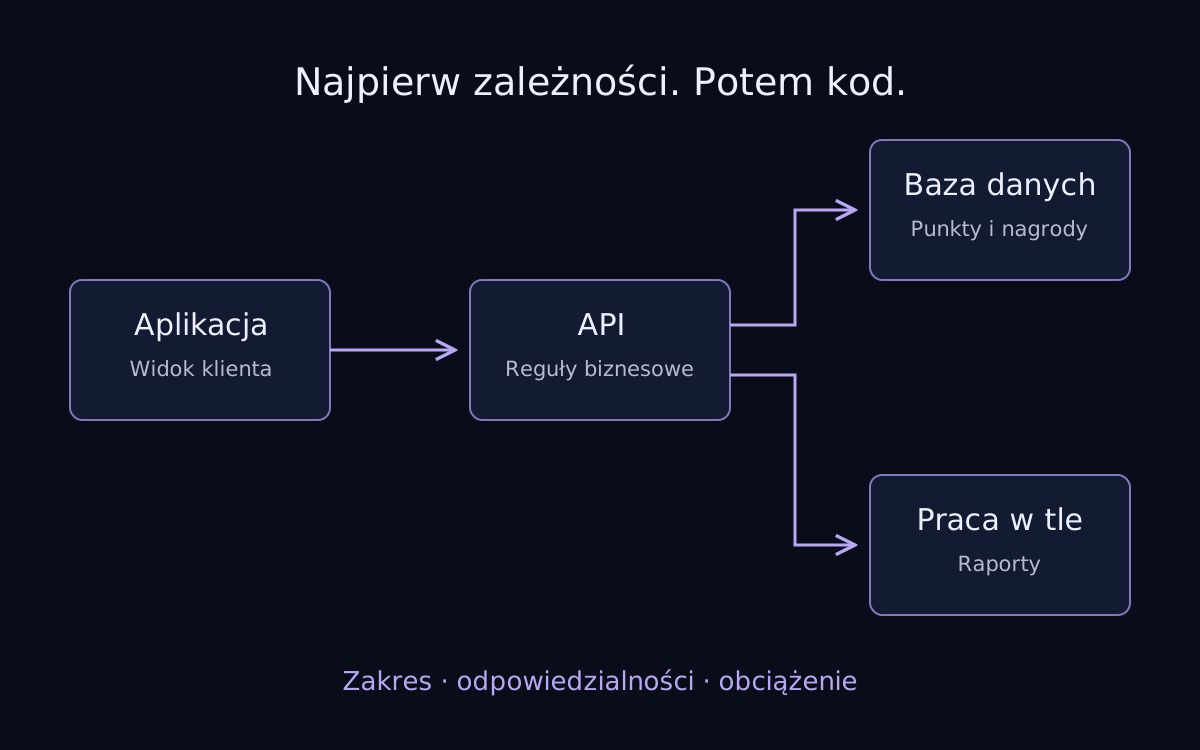
Dlatego projektowanie oprogramowania obejmuje również pytania o warunki jego pracy. Ile osób będzie korzystać z systemu? Co będą robiły? Jak szybko powinny otrzymać odpowiedź? Jakie dane trzeba przechowywać i z jakimi usługami się połączyć?
W Pracowni Kodu chcemy patrzeć na te zagadnienia jako część jednego projektu. Potrzeby biznesowe, architektura, technologia i koszty utrzymania wpływają na siebie.
Od czego zaczynamy
Dobry plan zaczyna się od zrozumienia pracy, którą system ma wykonać.
Weźmy aplikację lojalnościową. Klient sprawdza punkty i odbiera nagrodę. Pracownik rejestruje zakup. Właściciel analizuje wyniki.
Każda z tych czynności ma inne wymagania. Przyznanie nagrody wymaga poprawnego sprawdzenia i zapisania stanu punktów. Raport miesięczny może powstawać w tle. Przypomnienie wysłane klientowi kilka chwil później może być akceptowalne, podczas gdy długie oczekiwanie przy kasie będzie utrudniało obsługę.
Już na tym etapie warto ustalić, które operacje są najważniejsze, jakie opóźnienia można zaakceptować i co powinno się wydarzyć w przypadku błędu.
Po co rysować system
Narysowanie systemu pomaga zobaczyć zależności przed rozpoczęciem programowania.
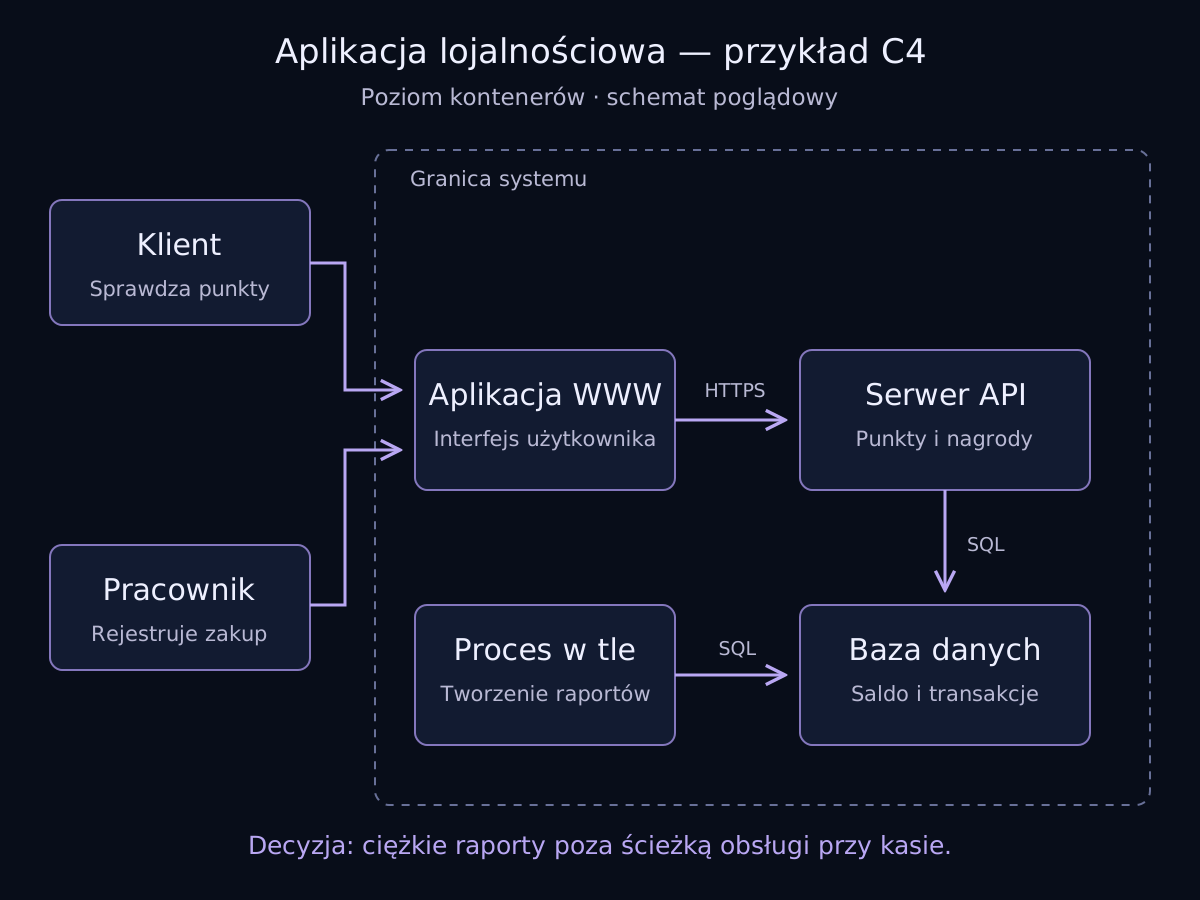
Jednym z narzędzi porządkujących architekturę jest model C4. Pozwala przedstawiać system na czterech poziomach szczegółowości:
- Kontekst: kto korzysta z systemu i z jakimi zewnętrznymi usługami się on łączy.
- Kontenery: główne aplikacje i magazyny danych, na przykład panel internetowy, serwer API i baza danych.
- Komponenty: podział odpowiedzialności wewnątrz wybranej części systemu.
- Kod: szczegóły implementacji tam, gdzie ich przedstawienie jest przydatne.
Nie każdy projekt potrzebuje wszystkich czterech poziomów. Oficjalna dokumentacja C4 wskazuje, że dla większości zespołów wystarczające są diagramy kontekstu i kontenerów. Model C4 — rodzaje diagramów.
Na takim schemacie łatwiej omówić, gdzie przechowujemy dane, kto odpowiada za naliczanie punktów i od czego zależy obsługa klienta. Można też uzupełnić go diagramem przebiegu konkretnej operacji, na przykład odebrania nagrody.
Sam rysunek nie potwierdza jeszcze wydajności ani niezawodności. Daje jednak wspólny punkt odniesienia do rozmowy i pomaga wskazać założenia, które trzeba później sprawdzić.
Jak mierzyć szybkość
Szybkość systemu warto opisać konkretnymi miarami.
Angielskie latency można w tym kontekście opisywać po polsku jako czas odpowiedzi. Trzeba przy tym określić, gdzie go mierzymy: wewnątrz serwera czy z perspektywy klienta, z uwzględnieniem komunikacji przez sieć.
Istotna jest również przepustowość, czyli liczba żądań obsługiwanych w określonym czasie, oraz odsetek błędów. System może szybko odpowiadać komunikatem o niepowodzeniu — taki wynik nie oznacza, że poprawnie obsługuje klientów.
Sama średnia czasu odpowiedzi także może ukrywać problemy. Dlatego obserwuje się między innymi 95. i 99. percentyl, oznaczane jako p95 i p99. Przykładowo p95 równy 500 milisekund oznacza, że około 95% zmierzonych odpowiedzi mieściło się w tym czasie, a pozostałe trwały dłużej. To przykład objaśniający miarę, a nie wynik naszego testu.
Google w materiałach dotyczących niezawodności zaleca obserwowanie czterech podstawowych sygnałów: czasu odpowiedzi, ruchu, błędów i stopnia wykorzystania zasobów. Google SRE — monitorowanie systemów.
Użytkownicy a żądania
Liczba użytkowników nie jest tym samym co liczba żądań.
Tysiąc zarejestrowanych osób może generować niewielki ruch, jeśli większość korzysta z aplikacji sporadycznie. Mniejsza grupa intensywnie pracujących użytkowników może obciążać ją znacznie bardziej.
Rozważmy prosty przykład rachunkowy: 200 aktywnych użytkowników, z których każdy wysyła jedno żądanie co pięć sekund, oznacza średnio 40 żądań na sekundę. Jeśli jedna czynność w aplikacji uruchamia trzy wywołania API, przy tej samej częstotliwości działań otrzymamy już 120 żądań na sekundę.
Do tego dochodzą chwilowe spiętrzenia ruchu. Powiadomienie o promocji może sprawić, że wiele osób otworzy aplikację jednocześnie. Dlatego w testach trzeba odtworzyć sposób korzystania z systemu, uwzględniając zarówno częstotliwość działań, jak i ich przebieg. Grafana k6 — modelowanie obciążenia API.
Node.js, Python i obciążenie
Dobór technologii wymaga zrozumienia rodzaju obciążenia.
Node.js dobrze nadaje się do obsługi wielu operacji związanych z oczekiwaniem na dane, pod warunkiem odpowiedniego zaprojektowania aplikacji. Gdy jedna operacja czeka na odpowiedź sieciową, środowisko może zajmować się innymi zadaniami. Długie obliczenia wykonywane na głównym wątku mogą jednak blokować obsługę pozostałych żądań. Zwraca na to uwagę sama dokumentacja Node.js. Node.js — unikanie blokowania obsługi żądań.
Python również umożliwia programowanie asynchroniczne. Biblioteka asyncio stanowi podstawę narzędzi do współbieżnej obsługi komunikacji sieciowej. W takim rozwiązaniu także trzeba uważać na operacje blokujące, a ciężką pracę odpowiednio przenosić poza pętlę obsługującą pozostałe zadania. Dokumentacja asyncio, wykonywanie kodu blokującego.
Dlatego porównanie „obie aplikacje mają po 20 punktów API” niewiele mówi o ich możliwościach. Jeden punkt może zwracać krótką informację, a drugi przeszukiwać duży zbiór danych i generować raport.
Rzetelne porównanie wymaga podobnego zadania, danych i limitów zasobów, jawnej konfiguracji oraz tych samych kryteriów poprawności i czasu odpowiedzi. Dopiero wtedy można ocenić, która implementacja lepiej odpowiada potrzebom projektu.
Testy obciążeniowe
Założenia dotyczące ruchu trzeba sprawdzić testami.
Test obciążeniowy pozwala obserwować system podczas wykonywania wielu operacji. Powinien obejmować rzeczywiste scenariusze, na przykład logowanie, sprawdzenie salda, zapis transakcji i odebranie nagrody. Oprócz szybkości należy sprawdzać poprawność odpowiedzi i zapisanych danych. Grafana k6 — testowanie API.
Warto sprawdzić kilka sytuacji:
- zwykły, przewidywany ruch;
- większe obciążenie w godzinach szczytu;
- nagły napływ użytkowników;
- wielogodzinną pracę, która może ujawnić narastające problemy;
- stopniowe zwiększanie ruchu, aby poznać granice systemu.
Takie scenariusze odpowiadają różnym rodzajom testów opisanym w dokumentacji k6. Rodzaje testów obciążeniowych.
Praktyczną granicą systemu jest już moment, w którym przestaje spełniać ustalone wymagania dotyczące czasu odpowiedzi, poprawności lub liczby błędów. Nie trzeba czekać na całkowite zatrzymanie serwera.
Warto również zaplanować zachowanie podczas przeciążenia: ograniczenie przyjmowanego ruchu, kontrolowane odrzucanie części żądań lub ograniczenie mniej ważnych funkcji. To pomaga chronić kluczowe operacje. Google SRE — obsługa przeciążenia.
Korzyści i ograniczenia
Każde rozwiązanie ma korzyści i koszty.
W projektowaniu systemów często używa się angielskiego określenia trade-off. Po polsku możemy mówić o kompromisie projektowym: wybierając daną korzyść, akceptujemy określone ograniczenie.
| Decyzja | Możliwa korzyść | Koszt lub ograniczenie |
|---|---|---|
| Przechowywanie części wyników w pamięci podręcznej | Szybsze odczyty i mniej pracy dla bazy | Trzeba zadbać o aktualność danych |
| Przeniesienie raportów do zadań w tle | Krótsze oczekiwanie na przyjęcie zlecenia | Gotowy raport pojawi się później |
| Podział aplikacji na osobne usługi | Możliwość niezależnego rozwijania i skalowania części systemu | Więcej połączeń, wdrożeń i elementów do utrzymania |
| Zwiększenie zasobów serwera | Większy zapas mocy, jeśli to zasoby są ograniczeniem | Wyższy koszt i brak rozwiązania części problemów w kodzie lub bazie |
Dobry projekt wymaga ustalenia, które korzyści są potrzebne konkretnej firmie. Dla niewielkiego systemu prostota utrzymania może być ważniejsza niż możliwość niezależnego skalowania wielu usług. W innym projekcie taka niezależność może uzasadniać dodatkową złożoność.
Plan rozwija się z projektem
Plan powinien rozwijać się razem z wiedzą o systemie.
Na początku określamy potrzeby, rysujemy najważniejsze zależności i zapisujemy założenia. Gdy pojawia się działający fragment aplikacji, sprawdzamy je pomiarami. Wyniki mogą prowadzić do zmiany sposobu przechowywania danych, podziału zadań albo konfiguracji infrastruktury.
Warto zachować krótkie uzasadnienia ważnych decyzji: dlaczego wybraliśmy dane rozwiązanie, jakie alternatywy rozważaliśmy i w jakich warunkach będziemy musieli wrócić do tematu.
W Pracowni Kodu chcemy projektować oprogramowanie z uwzględnieniem sposobu działania firmy, jej budżetu i planów rozwoju. Schemat pomaga zrozumieć system, pomiary pozwalają sprawdzić założenia, a świadome decyzje ułatwiają jego późniejsze utrzymanie.
Przykład takiego podziału opisaliśmy w artykule o architekturze ReasonReach. Jeśli planujesz własną aplikację, zobacz, jak podchodzimy do tworzenia systemów dedykowanych, albo uporządkuj zakres w planerze projektu.